
Estimated reading time: 10 minutes
„RAG verbindet KI mit Ihren eigenen Dokumenten: Wie Chunking, Embeddings, Vektordatenbank und Berechtigungen belastbare, geprüfte Antworten liefern.“ – Net Professionals
Was ist RAG?
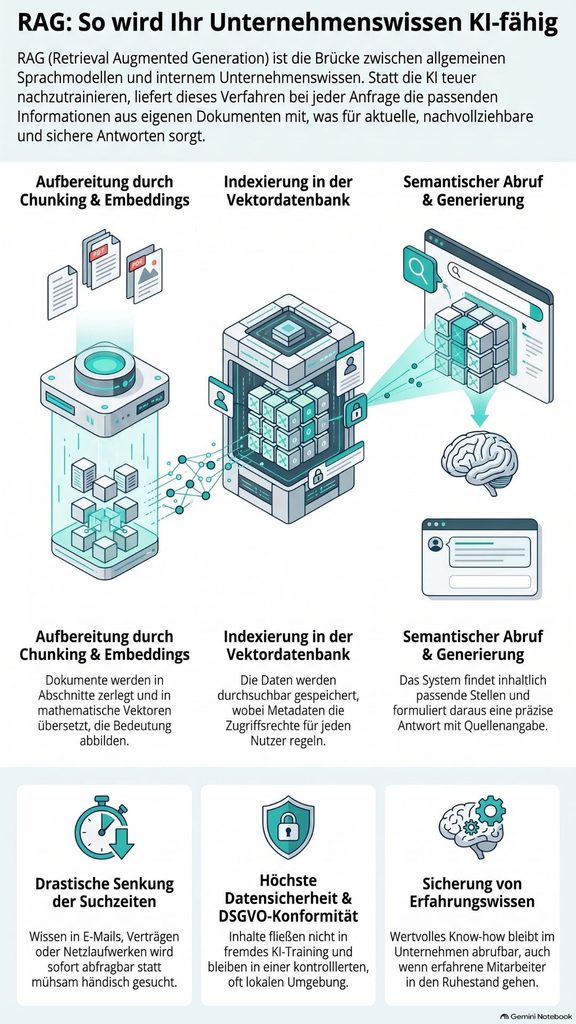
RAG steht für Retrieval Augmented Generation. Gemeint ist ein Verfahren, das ein Sprachmodell mit Ihren eigenen Dokumenten verbindet. Zuerst sucht das System passende Textstellen heraus. Danach beantwortet das Modell die Frage genau auf Basis dieser Fundstellen.
Der Unterschied zu einem allgemeinen Assistenten ist deutlich. Ein Sprachmodell kennt nämlich nur das, was es beim Training gesehen hat. Ihre Angebote, Verträge und Arbeitsanweisungen gehören sicher nicht dazu. Deshalb liefert es zu internen Fragen allgemeine oder schlicht falsche Antworten.
Mit RAG ändert sich diese Ausgangslage grundlegend. Das Modell erhält bei jeder Anfrage die passenden Auszüge aus Ihrem Wissensbestand mitgeliefert. Somit entsteht aus einem allgemeinen Werkzeug ein Assistent, der Ihr Unternehmen kennt. Zusätzlich kann er seine Quellen benennen.
Warum RAG für Unternehmen wichtig geworden ist
In vielen Betrieben liegt Wissen verstreut über Jahrzehnte. Es steckt in Dateiablagen, E-Mails, Datenbanken und in den Köpfen einzelner Personen. Die Suche danach kostet täglich Zeit. Genau hier setzt RAG an, denn es macht diesen Bestand endlich abfragbar.
- Weniger Suchzeit: Zuerst entfällt das mühsame Durchklicken durch verschachtelte Ordner.
- Aktuelle Antworten: Danach ist ein neues Dokument sofort nach dem Einlesen verfügbar.
- Nachvollziehbarkeit: Zudem verweist jede Antwort auf die konkrete Fundstelle.
- Weniger Halluzinationen: Außerdem sinkt das Risiko erfundener Aussagen deutlich.
- Wissenssicherung: Schließlich bleibt Erfahrungswissen erhalten, wenn Mitarbeiter das Haus verlassen.
Besonders wertvoll ist der letzte Punkt für kleinere Betriebe. Denn dort hängt viel Wissen an wenigen erfahrenen Personen. Geht eine davon in Pension, entsteht eine spürbare Lücke. Ein gut gepflegter Wissensbestand federt diesen Verlust zumindest teilweise ab.
Wie eine RAG-Lösung technisch funktioniert
Der Ablauf besteht aus zwei Phasen. Zunächst werden die Dokumente einmalig aufbereitet und in einen durchsuchbaren Index überführt. Danach läuft bei jeder Frage der eigentliche Abruf. Beide Phasen lassen sich getrennt voneinander optimieren.
- Chunking: Zuerst werden Dokumente in sinnvolle Abschnitte zerlegt.
- Embeddings: Danach wird jeder Abschnitt in einen Zahlenvektor übersetzt, der seine Bedeutung abbildet.
- Vektordatenbank: Zudem speichert eine spezielle Datenbank diese Vektoren durchsuchbar ab.
- Retrieval: Außerdem liefert sie zu jeder Frage die inhaltlich ähnlichsten Abschnitte.
- Antwortgenerierung: Schließlich formuliert das Sprachmodell die Antwort aus genau diesen Auszügen.
Entscheidend ist dabei die semantische Suche. Sie findet nämlich auch Treffer, die andere Wörter verwenden als die Frage. Wer nach Urlaubsanspruch sucht, erhält somit ebenso Abschnitte zum Erholungsurlaub. In der Praxis kombinieren wir diesen Ansatz zusätzlich mit klassischer Stichwortsuche.
RAG oder eigenes Training: Was ist sinnvoller?
Häufig fällt die Frage nach dem Fine-Tuning. Dabei würde ein Modell mit eigenen Daten nachtrainiert. Für die meisten Unternehmen ist RAG jedoch der bessere Weg. Denn Wissen ändert sich laufend, ein Training dagegen ist aufwendig und teuer.
- Aktualität: Zuerst spricht dafür, dass neue Dokumente sofort wirksam werden.
- Kosten: Danach entfällt der wiederkehrende Aufwand für jedes Nachtraining.
- Quellenangaben: Zudem lässt sich jede Aussage auf ein konkretes Dokument zurückführen.
- Löschbarkeit: Außerdem verschwindet ein entfernter Inhalt sofort aus den Antworten.
- Datenschutz: Schließlich wandern Ihre Inhalte nicht in die Gewichte eines fremden Modells.
Fine-Tuning bleibt trotzdem sinnvoll, allerdings für andere Ziele. Es prägt vor allem Stil, Tonfall und Antwortformat. Für reines Fachwissen ist es dagegen kaum geeignet. Deshalb empfehlen wir bei Wissensfragen fast immer den Weg über RAG.
Der Knackpunkt: Berechtigungen richtig abbilden
An dieser Stelle scheitern viele Projekte. Denn ein Assistent findet alles, was im Index liegt. Ohne Schutz sieht die Assistentin plötzlich Gehaltslisten, und der Praktikant liest Kündigungsentwürfe. Deshalb gehört das Berechtigungskonzept an den Anfang jedes Vorhabens.
- Rechte am Index: Zuerst muss die Suche selbst nach Berechtigungen filtern.
- Keine Prompt-Lösung: Danach gilt: Eine Anweisung im Prompt ersetzt niemals eine echte Zugriffsprüfung.
- Metadaten: Zudem wird jedem Abschnitt hinterlegt, wer ihn sehen darf.
- Aktualisierung: Außerdem müssen Rechteänderungen zeitnah im Index ankommen.
- Protokollierung: Schließlich bleibt nachvollziehbar, wer welche Inhalte abgerufen hat.
In der Praxis legt ein solches Projekt schonungslos offen, wie gewachsen viele Ablagen sind. Häufig sind Ordner über Jahre zu weit freigegeben worden, ohne dass es jemandem auffiel. Deshalb steht die Bereinigung der Zugriffsrechte immer vor der Technik. Somit verbessert bereits die Vorbereitung Ihre IT-Sicherheit spürbar.
Datenqualität entscheidet über die Antwortqualität
Ein Wissenssystem ist nur so gut wie sein Bestand. Liegen drei Versionen derselben Preisliste im Index, wird die Antwort zwangsläufig unzuverlässig. Deshalb gehört zu jedem Projekt eine ehrliche Bestandsaufnahme. Erst danach folgt der technische Aufbau.
- Doppelte Ablagen: Zuerst werden veraltete Kopien und Entwürfe aussortiert.
- Gültigkeit: Danach erhält jedes Dokument einen klaren Stand und einen Verantwortlichen.
- Formate: Zudem müssen gescannte Unterlagen erst per Texterkennung lesbar gemacht werden.
- Struktur: Außerdem helfen Überschriften und Metadaten der Suche erheblich.
- Pflegeprozess: Schließlich braucht der Bestand eine feste Zuständigkeit für Aktualisierungen.
Der Aufwand dafür wird regelmäßig unterschätzt. Denn die Technik ist heute vergleichsweise schnell aufgesetzt. Die Aufbereitung der Inhalte kostet dagegen deutlich mehr Zeit. Trotzdem lohnt sich diese Arbeit, weil auch die klassische Suche davon profitiert.
Typische Anwendungsfälle im Unternehmen
Der Einstieg gelingt am besten mit einem klar abgegrenzten Wissensbereich. Dieser sollte überschaubar sein und häufig genutzt werden. Zudem müssen die Antworten leicht überprüfbar bleiben. Folgende Bereiche haben sich dafür bewährt.
- Interner Helpdesk: Zuerst beantwortet das System wiederkehrende Fragen zu IT und Abläufen.
- Angebotserstellung: Danach findet der Vertrieb frühere Angebote und passende Textbausteine.
- Technische Dokumentation: Zudem werden Handbücher und Wartungsanleitungen direkt durchsuchbar.
- Verträge und Richtlinien: Außerdem lassen sich Fristen und Klauseln gezielt nachschlagen.
- Einarbeitung: Schließlich finden neue Mitarbeiter Antworten, ohne ständig nachfragen zu müssen.
Anbinden lassen sich dabei auch gewachsene Systeme. Über passende Schnittstellen erreichen wir ebenso Dokumentenablagen, Datenbanken und langjährig bewährte Fachanwendungen. Ein kompletter Systemwechsel ist dafür nicht nötig. Vielmehr ergänzt die Schnittstellen-Entwicklung Ihre bestehende Umgebung.
Datenschutz, DSGVO und EU AI Act
RAG gilt datenschutzrechtlich als vergleichsweise günstige Variante. Denn Ihre Inhalte bleiben in einer eigenen Datenbank und fließen nicht in fremdes Training. Trotzdem gelten alle üblichen Pflichten. Deshalb klären wir den rechtlichen Rahmen vor dem ersten Testlauf.
- Verarbeitungsverzeichnis: Zuerst wird das System als eigene Verarbeitungstätigkeit erfasst.
- Standortfrage: Danach entscheidet sich, wo Index und Sprachmodell tatsächlich betrieben werden.
- Löschkonzept: Zudem muss ein gelöschtes Dokument auch aus dem Index verschwinden.
- Auskunftsrechte: Außerdem bleiben Betroffenenrechte an personenbezogenen Inhalten bestehen.
- EU AI Act: Schließlich verlangt die Verordnung Transparenz und ausreichend geschultes Personal.
Für besonders sensible Bestände empfehlen wir den Betrieb im eigenen Haus. Vektordatenbank und Sprachmodell laufen dann im österreichischen Rechenzentrum. Somit verlassen die Inhalte Ihre kontrollierte Umgebung zu keinem Zeitpunkt. Ergänzend dokumentieren wir jeden Verarbeitungsschritt nachvollziehbar.
RAG Schritt für Schritt einführen
Ein Wissenssystem entsteht nicht in einem großen Wurf. Vielmehr bewährt sich der Start mit einem einzelnen, gut gepflegten Bereich. Zuerst wird gemessen, wie viel Zeit die Suche heute kostet. Danach zeigt der Vergleich, was die Lösung tatsächlich bringt.
Wichtig bleibt außerdem die laufende Bewertung der Antworten. Denn ein Index veraltet, und Fragen verändern sich mit der Zeit. Deshalb prüfen wir regelmäßig Stichproben und passen die Aufbereitung an. Somit bleibt RAG auch nach Jahren verlässlich und nützlich.
Key Findings
| Aspekt | Details |
| Definition | RAG verbindet ein Sprachmodell mit den eigenen Dokumenten. Passende Auszüge werden gesucht und der Antwort als Grundlage mitgegeben. |
| Ablauf | Chunking, Embeddings und Vektordatenbank bilden die Vorbereitung. Beim Abruf folgen semantische Suche und Antwortgenerierung. |
| Gegenüber Fine-Tuning | RAG ist aktueller, günstiger und nachvollziehbarer. Fine-Tuning eignet sich eher für Stil und Antwortformat als für Fachwissen. |
| Berechtigungen | Die Suche selbst muss nach Rechten filtern. Eine Anweisung im Prompt ersetzt niemals eine echte Zugriffsprüfung. |
| Datenqualität | Doppelte Ablagen und veraltete Versionen verderben jede Antwort. Die Aufbereitung kostet mehr Zeit als die Technik. |
| Anwendungsfälle | Interner Helpdesk, Angebotserstellung, technische Dokumentation, Verträge und Einarbeitung eignen sich besonders gut für den Einstieg. |
| Recht | DSGVO-Pflichten bleiben bestehen, insbesondere Löschkonzept und Verarbeitungsverzeichnis. Sensible Bestände laufen besser im eigenen Haus. |
Ihr Unternehmenswissen nutzbar machen – mit Net Professionals
Sie möchten wissen, ob sich ein eigenes Wissenssystem für Ihren Betrieb rechnet? Dann beginnen Sie am besten mit einem klar abgegrenzten Bereich statt mit der gesamten Ablage. Net Professionals betreut seit über 25 Jahren IT-Infrastruktur, Cloud Services und individuelle Softwarelösungen in Wien und Niederösterreich. Zudem hosten wir in Österreich und arbeiten nach ISO/IEC 27001.
Zunächst prüfen wir Datenbestand, Berechtigungen und mögliche Anwendungsfälle. Danach entsteht ein überschaubarer Pilot mit messbaren Zielen. Anschließend erhalten Sie eine verständliche Empfehlung samt Aufwandsschätzung. Ihre Daten bleiben dabei geschützt, denn wir arbeiten durchgehend DSGVO-konform.
Entdecken Sie die KI-Lösungen von Net Professionals
FAQs
RAG bedeutet Retrieval Augmented Generation, also abrufgestützte Antworterzeugung. Das System sucht zuerst passende Abschnitte in Ihren eigenen Dokumenten. Danach formuliert ein Sprachmodell die Antwort ausschließlich aus diesen Fundstellen.
Nein, aber es senkt das Risiko deutlich. Da jede Aussage auf konkrete Fundstellen zurückgeht, lassen sich Antworten überprüfen. Deshalb sollten Quellenangaben immer sichtbar bleiben und Stichproben fest eingeplant werden.
Die Suche selbst muss nach Berechtigungen filtern, bevor Inhalte an das Modell gelangen. Eine Anweisung im Prompt genügt dafür nicht. Deshalb steht die Bereinigung der Zugriffsrechte immer am Anfang des Projekts.
Am besten ein gepflegter, häufig genutzter Bereich wie Handbücher, Richtlinien oder Serviceunterlagen. Gescannte Unterlagen brauchen vorab eine Texterkennung. Veraltete Versionen sollten vor dem Einlesen aussortiert werden.
Das hängt vom gewählten Betriebsmodell ab. Vektordatenbank und Sprachmodell lassen sich vollständig im eigenen oder gehosteten Rechenzentrum betreiben. Bei sensiblen Beständen empfehlen wir genau diese Variante.